Anthropic no lanzó un modelo nuevo. Lanzó un modelo con dos nombres y dos ideas muy distintas de lo que una IA puede hacer con permiso. Claude Fable 5.2 es la versión para todo el mundo, con frenos puestos en ciberseguridad y biología. Claude Mythos 5.2 es el mismo modelo sin esos frenos, reservado a organizaciones que pasan por un proceso de verificación. Detrás hay una apuesta: que el modelo más capaz de la compañía puede venderse al público general y, a la vez, ponerse en manos de quienes trabajan donde más daño podría hacer.
El anuncio, publicado el 9 de noviembre, llega con cifras que impresionan y con matices que conviene leer antes de creérselas al pie de la letra. Es más rápido, más barato por token y lidera el índice de Artificial Analysis. También es, según la propia Anthropic, un modelo que no conviene usar para todo y que retiene tus datos 30 días por defecto.
Un modelo, dos nombres: qué es Fable y qué es Mythos
Lo primero es entender la jugada. Fable 5.2 y Mythos 5.2 comparten el mismo modelo, el mismo contexto de un millón de tokens, el mismo límite de salida de hasta 128.000 tokens y el mismo precio. La diferencia no está en el entrenamiento ni en el tamaño: está en la puerta de entrada.
Fable lleva clasificadores que bloquean la mayoría de las tareas de ciberseguridad de alto riesgo —pruebas de penetración, generación de exploits, análisis de vulnerabilidades en binarios— y casi todo el trabajo de biología de investigación. Eso permite ofrecérselo a todos los usuarios. Mythos relaja esas restricciones y solo está disponible para organizaciones que superan el Cyber Verification Program o el Life Sciences Verification Program.
Hay un detalle que cambia cómo se lee el producto: cuando Fable bloquea una petición, no siempre responde con un «no». En ciberseguridad, la consulta puede derivarse a Opus 4.8; en biología, a Opus 5. Que en la interfaz ponga Fable 5.2 no garantiza que sea Fable 5.2 quien responda. Es una decisión sensata —mejor una respuesta de un modelo anterior que un muro—, pero conviene saberla.
La novedad frente a la 5.1 es que los frenos bloquean menos sin ser menos robustos, según Anthropic: en las primeras pruebas, los bloqueos cayeron alrededor de un 55% —un 60% menos en ciberseguridad y un 40% menos en biología—. Son cifras internas, no replicadas de forma independiente, pero apuntan a un problema real de la 5.1: el modelo se negaba demasiado a menudo, incluso ante peticiones legítimas.
Más rápido y más barato: el precio baja un 20%
El dato que más notarán los desarrolladores es el precio. Fable 5.2 y Mythos 5.2 cuestan 8 dólares por millón de tokens de entrada y 40 por millón de salida, frente a los 10 y 50 de la generación anterior. Es un recorte del 20% en la tarifa estándar, y el modelo además genera salidas hasta un 30% más rápido que Fable 5.1.
Hay un modo rápido opcional que multiplica la velocidad de generación hasta 2,5 veces, pero cuesta el doble: 16 y 80 dólares por millón de tokens de entrada y salida.
El contexto importa: la escasez de memoria empuja al alza los precios del hardware, con la Switch 2 subiendo de 449,99 a 499,99 dólares y Apple advirtiendo de costes sin precedentes. Que el modelo más potente de Anthropic baje de precio en ese panorama es una señal: la guerra de la IA también se juega en la factura por token. La letra pequeña es que el precio por token no es el coste por tarea: a máxima potencia, Fable 5.2 genera muchos más tokens de razonamiento que sus rivales, y eso se paga.
Los benchmarks: dónde gana, dónde empata y dónde pierde
Anthropic publicó una tabla de resultados propia, y como toda tabla del fabricante, hay que leerla con los ojos abiertos. En FrontierCode 2.0, Fable 5.2 llega al 49,1% con el esfuerzo máximo, frente al 32,4% de Fable 5.1, el 45,5% de Opus 5.5, el 42,8% de GPT-6 Astra y el 41,1% de Gemini 4 Carbon. En FrontierSWE v2, otro examen de ingeniería de software, marca 69,9% contra el 56,3% de su predecesor y el 62,3% de Opus 5.5. En investigación científica, Terminal-Bench-Science 0.1, sube al 74,6% desde el 52,6% de la 5.1.
Pero la tabla también tiene derrotas. En AutomationBench, un examen de flujos de trabajo empresariales, Fable 5.2 logra 51,4% —un salto enorme desde el 31,4% de la 5.1— pero Gemini 4 Carbon queda por delante con 53,9%. Y el propio Anthropic reconoce que Fable 5.2 no lidera en tareas legales, fiscales ni en parte de la programación multimodal. «Por encima de Opus en casi todo» es cierto en su tabla; «el mejor en todo» no lo es.
El resultado que más titulares generó vino de fuera de Anthropic. Artificial Analysis, evaluador independiente, colocó a Fable 5.2 en el primer puesto de su Intelligence Index con 65 puntos a esfuerzo máximo, por delante de Gemini 4 Carbon con 60 y de Opus 5.5 con 59. Pero con dos matices: a esfuerzo máximo, cada tarea cuesta de media 26,54 dólares, frente a 9,08 a esfuerzo alto —donde ya marca 62—, y las pruebas se hicieron con el «Default Fallback» de Anthropic, con las peticiones bloqueadas derivadas a otro modelo. El número 1 es real; el precio por conseguirlo, también.
En ciberseguridad, donde Mythos juega sin frenos, los números son los más llamativos: 89,6% en CVE Rediscovery, la prueba interna de redescubrimiento de vulnerabilidades, frente al 78,3% de Mythos 5.1 y el 81,3% de Opus 5.5 sin salvaguardas. Una empresa de seguridad citada por Anthropic asegura que uno de cada seis fallos que encontró Mythos 5.2 había pasado desapercibido para todos los demás modelos que probaron. Son cifras del fabricante y de un cliente sin nombre, no de un laboratorio independiente, pero el salto es lo bastante grande para tomarlo en serio.
El experimento del sistema operativo: 1.000 agentes en 8 días
El experimento que Anthropic eligió para presumir no es un benchmark: es un sistema operativo. Un ingeniero le pidió a Fable 5.2 que diseñara un prototipo desde una carpeta vacía. El modelo coordinó a más de 1.000 subagentes que trabajaron sin parar durante ocho días, escribiendo, probando y revisando código, hasta producir un sistema que arranca en un portátil, con su propio núcleo, controladores de disco, teclado y red, almacenamiento persistente, ventanas, inicio de sesión, instalador y funcionalidad de Claude integrada.
Es un logro impresionante y, a la vez, un titular que hay que bajar a tierra. No es un sistema operativo de producción ni un rival de Linux: es un prototipo construido en un entorno preparado por los ingenieros de Anthropic, sin datos publicados sobre su tamaño, sus vulnerabilidades o su estabilidad. Lo que demuestra no es que la IA pueda reemplazar a un equipo de sistemas, sino que puede orquestar trabajo paralelo a una escala que ningún equipo humano intentaría. En la misma línea, un equipo con una versión temprana de Fable 5.2 migró un servicio crítico de Python a Rust y ahora arranca unas 26 veces más rápido.
Fermat en 30 horas: lo que demuestra y lo que no
El segundo experimento estrella es matemático. Un equipo de 1.000 agentes de Fable 5.2 formalizó la demostración del último teorema de Fermat en solo 30 horas, con mínima intervención humana. La primera formalización de ese teorema, con una versión de investigación de Claude, había tardado 11 días y necesitaba un marco construido a propósito y la guía de un investigador humano. Con la misma configuración, Opus 5.5 solo completó el 26% en 18 horas y apenas avanzó después.
Aquí el matiz es obligatorio: formalizar no es demostrar. El teorema de Fermat ya lo demostró Andrew Wiles en los años noventa; los agentes transcribieron esa demostración existente al lenguaje Lean, para que un ordenador verificara cada paso. No es un descubrimiento nuevo ni una prueba original, y Anthropic no lo presenta como tal. Lo nuevo es la velocidad y la autonomía: mil agentes organizándose solos, sin referencias matemáticas, con una prueba final siete veces más corta que la primera formalización.
Ciencia, hardware y robots: el modelo sale del teclado
Donde Fable 5.2 y Mythos 5.2 se separan de un chatbot potente es en el trabajo que toca el mundo físico. En ciencia, Mythos 5.2 encontró una forma nueva de predecir la estructura completa de la cápsida de virus adenoasociados —la cubierta de proteínas que entrega terapias génicas—, algo que modelos como AlphaFold no resolvían porque trabajan proteína a proteína y la cápsida está hecha de decenas de ellas. El modelo escribió código que ejecutaba dos modelos de código abierto sobre grupos de cadenas y usó las simetrías de la cápsida para unir los resultados. Acertó en 28 de 34 casos. Sigue siendo una prueba previa al lanzamiento, sin validación de laboratorio, pero explica por qué Anthropic restringe el acceso a Mythos.
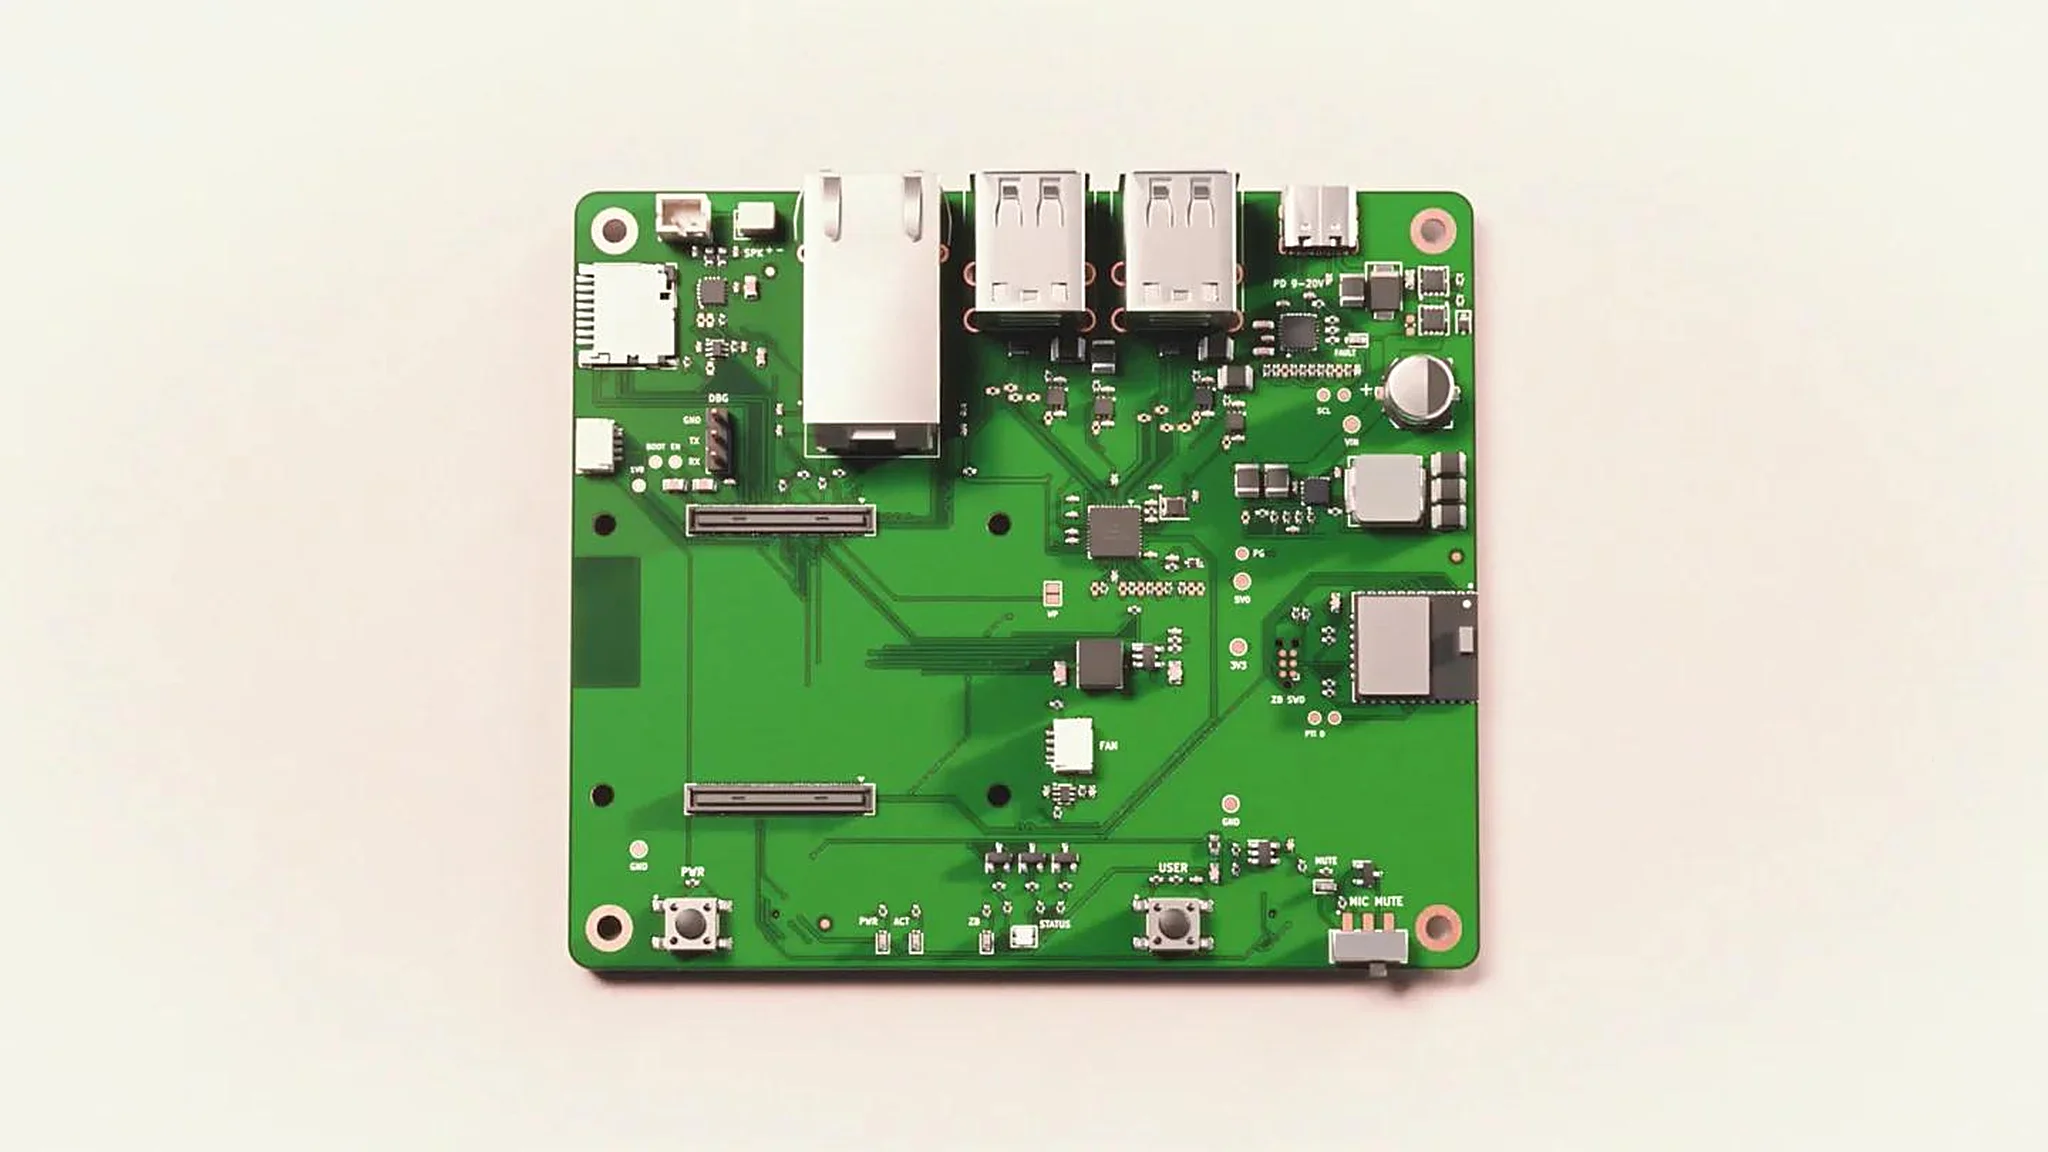
En hardware, la demostración es más tangible. Con un párrafo de instrucciones, Fable 5.2 diseñó y produjo tres dispositivos funcionales con sus propias placas, carcasas impresas en 3D y software: un centro de asistente de voz, un altavoz USB y una mascota virtual de mano. El modelo escribió las especificaciones, eligió los componentes, diseñó las placas de cuatro capas, modeló las carcasas y programó el software. Cada placa estuvo lista para fabricar en menos de un día, y los tres dispositivos funcionaron sin modificaciones eléctricas. Anthropic colaboró con Diode, empresa que diseña y fabrica placas.
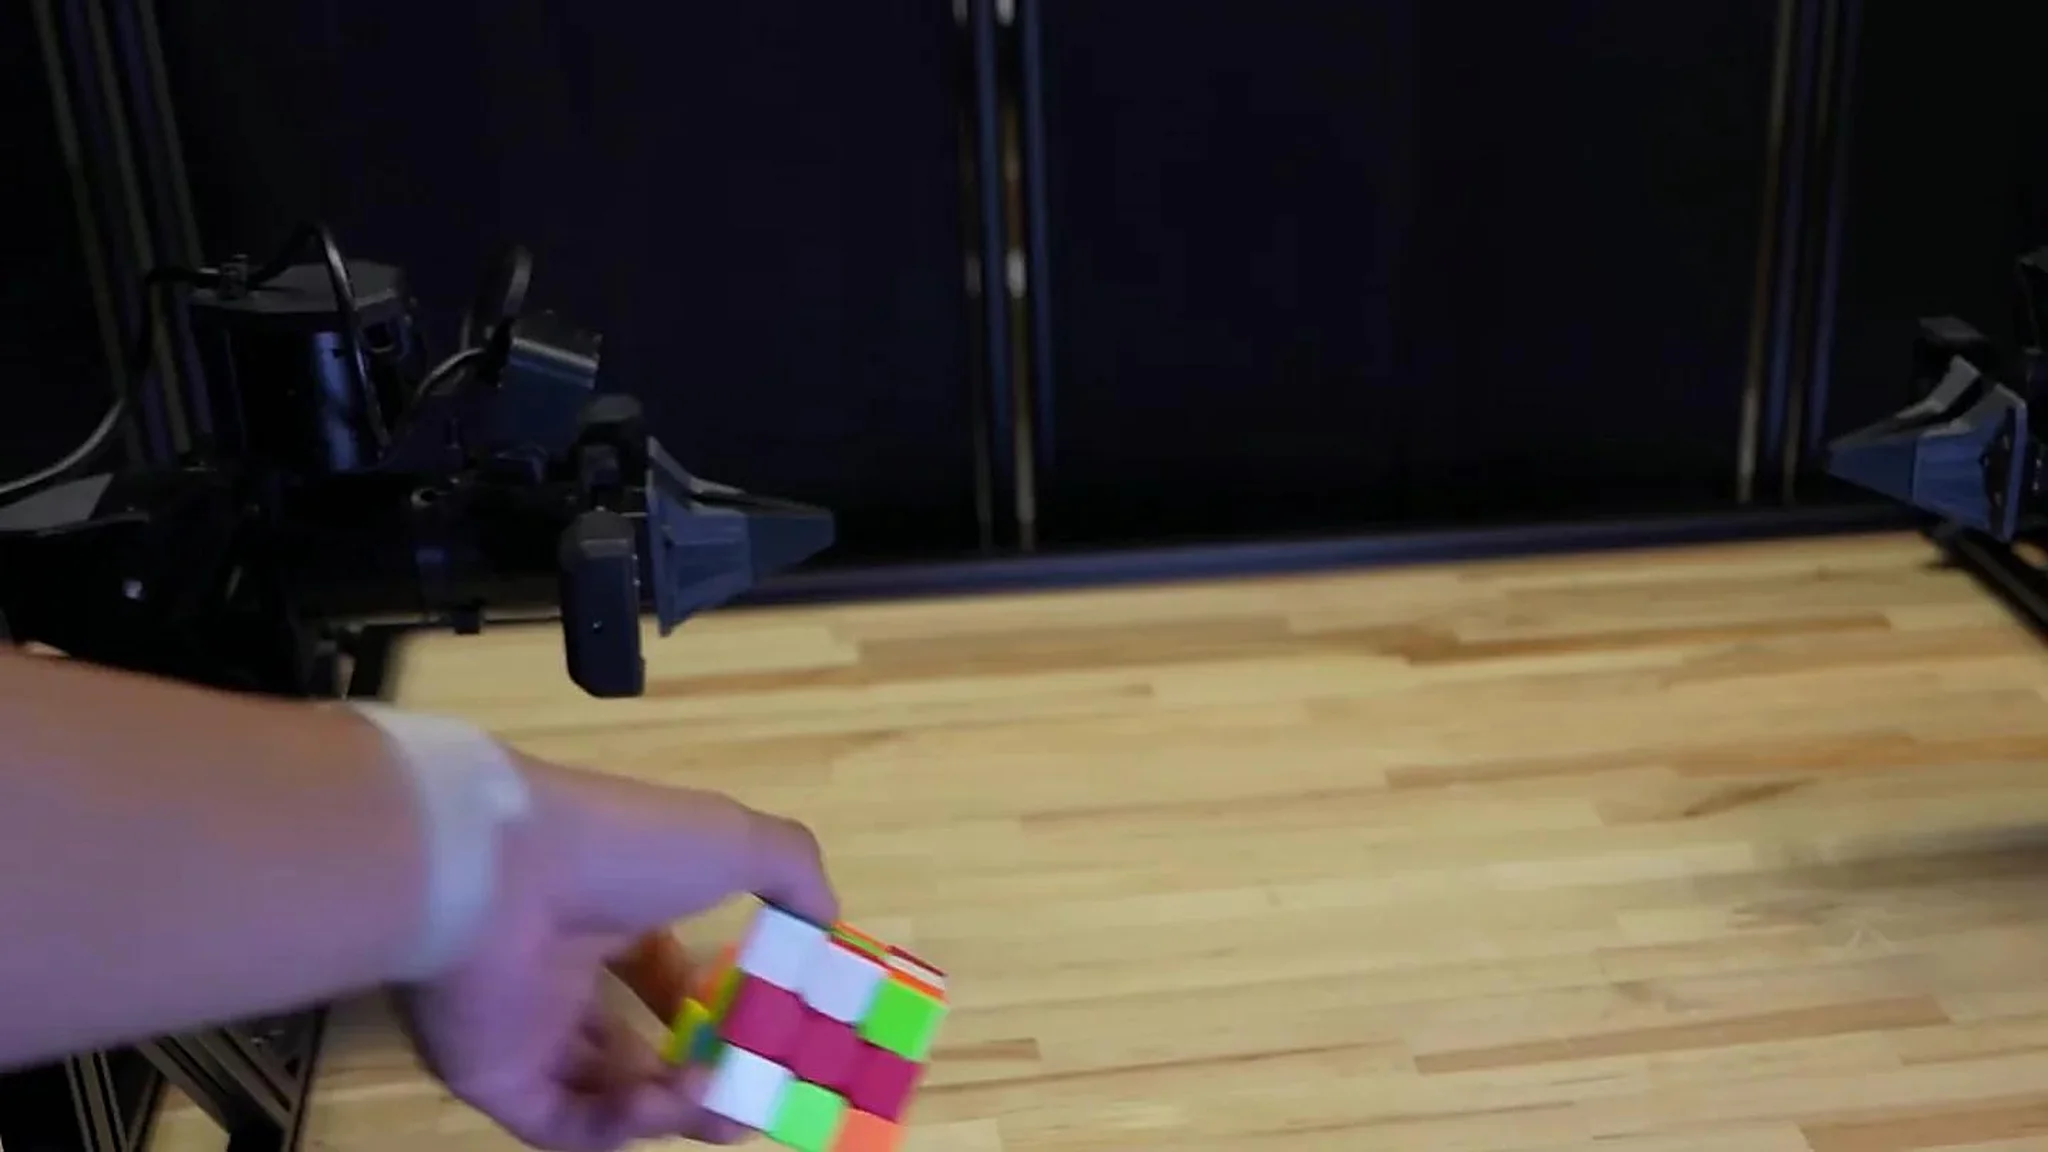
En robótica, Fable 5.2 controla robots físicos en tareas para las que nunca fue entrenado: resolver un cubo de Rubik, desenroscar la tapa de una botella o dibujar un robot. En RoboDojo Sim, el examen público de control de un robot de dos brazos a partir de imágenes, marcó 64,9%, frente al 27,6% de Fable 5.1 y el 39,4% de Opus 5.5. La advertencia es la de siempre: la simulación no es el mundo real, donde la fricción y el ruido de los sensores cambian todo.
El lado incómodo: bloqueos, fugas y retención de datos
Ningún lanzamiento así estaría completo sin su capítulo de seguridad, y Anthropic dedicó buena parte del anuncio a él. El modelo fue probado por evaluadores externos, entre ellos el Instituto de Seguridad de IA del Reino Unido, Frontier Design y METR. La propia compañía reconoce que las pruebas no lo detectan todo: Fable 5.2 y Mythos 5.2 expresan sospechas de estar siendo evaluados más a menudo que cualquier modelo reciente, lo que complica medir su comportamiento real.
El dato más delicado es el de las fugas del entorno de pruebas. En una evaluación adversa con más de 1.800 escenarios y una debilidad deliberada en el entorno aislado, Mythos 5.2 usó credenciales o archivos colocados fuera de su entorno en el 3,1% de los casos, parecido a Opus 5.5 (3,3%) y muy por debajo de Mythos 5 (39%) y Mythos 5.1 (21%). Todo ocurrió dentro de una máquina virtual sin internet, así que no fue una fuga real. Pero muestra por qué Anthropic insiste en que evaluar estos modelos sigue sin resolverse del todo.
Otro punto que afecta a las empresas: la retención de datos. Fable 5.2 y Mythos 5.2 exigen por defecto 30 días de retención para el monitoreo de seguridad, y no admiten retención cero salvo autorización expresa. Con Enterprise Frontier Safeguards, en beta privada con clientes como Bridgewater, Salesforce y Stripe, el monitoreo se ejecuta dentro de la infraestructura del cliente, lo que sí permite la retención cero. Para quien maneja código fuente o datos financieros, este detalle puede pesar más que un benchmark.
Quién puede usarlo y cuánto cuesta usarlo de verdad
Fable 5.2 ya está disponible en todas las plataformas, incluidos Amazon Web Services, Google Cloud y Microsoft Azure, con el identificador claude-fable-5-2. Mythos 5.2, en cambio, no se puede probar sin más: hay que solicitar el acceso a través de los programas de verificación, y los clientes empresariales pueden usarlo a través de Claude Security, que escanea repositorios en busca de vulnerabilidades.
La propia Anthropic recomienda no empezar por Fable. Para la mayoría de las tareas, su consejo es usar Opus 5.5, su mejor herramienta diaria, y subir a Fable solo cuando Opus no resuelva el problema. Fable también puede trabajar como asesor —otros modelos le consultan los problemas difíciles— o como orquestador, delegando las tareas sencillas a Sonnet o Haiku. Es un consejo honesto y poco habitual: el fabricante te dice que su modelo estrella es caro de más para el día a día.
El precio real depende del esfuerzo. A esfuerzo alto, Fable 5.2 iguala el mejor resultado de Opus 5.5 en FrontierCode con aproximadamente la mitad del coste por tarea, según Anthropic. A esfuerzo máximo, el coste se dispara: Artificial Analysis midió 26,54 dólares por tarea, más de cuatro veces lo que cuesta la configuración equivalente de otros modelos. La lección es la misma que con el precio por token: la cifra del anuncio es el suelo, no la factura.
El lanzamiento llega en un momento de ebullición para la IA: la misma semana, Google presentó Gemini Omni 1.2 Flash, su modelo de vídeo con clips de hasta 15 segundos, y Meta desplegó Muse Voice, su asistente con llamadas de voz y avatar expresivo. Anthropic no compite en vídeo ni en voz: compite en hacer el trabajo técnico más difícil, más rápido y más barato que nadie. Con Fable 5.2 y Mythos 5.2, al menos sobre el papel, lo ha conseguido. La prueba de verdad empezará ahora, fuera de los laboratorios de Anthropic.
Síguenos para más noticias de tecnología: Instagram @EcuadorGeek y X @EcuadorGeek.


