Google no anunció un modelo más. Anunció el modelo que llevaba dos semanas guardando para un grupo pequeño de defensores de ciberseguridad y que ahora abre a todo el que pague. Gemini 4 Carbon llegó el 10 de noviembre como el modelo más potente de la compañía, con un precio de lanzamiento que es exactamente la cuarta parte del de su rival directo, y con una fecha de caducidad: el 30 de noviembre se duplica.
La jugada es transparente. Carbon no compite en ser el modelo de todos los días. Compite en ser el modelo para lo más difícil —código largo, seguridad y ciencia— y en hacerlo más barato por tarea que nadie. La pregunta es si los números que Google enseña aguantan fuera de su propio escaparate. En parte sí, en parte no, y la parte que no es justo la que más titulares generó.
Todo lo que sigue sale del anuncio oficial de Google del 10 de noviembre y del anuncio original del 28 de octubre, y se marca qué es afirmación de Google y qué es dato independiente verificado el 11 de noviembre.
Qué es Carbon y por qué Google lo guardó dos semanas
Carbon se anunció el 28 de octubre, en un texto firmado por Koray Kavukcuoglu, vicepresidente de Google DeepMind, y desde el primer párrafo Google lo llamó su modelo más potente, con «ciberseguridad de última generación y capacidades de largo alcance». Pero no lo abrió a nadie: durante dos semanas solo lo usó un grupo de defensores de ciberseguridad dentro de su programa Fairwind, mientras Google lo sometía al proceso voluntario de pruebas previas del gobierno de Estados Unidos y pulía sus salvaguardas. El 10 de noviembre llegó la apertura general.
Carbon se construye sobre Gemini 4 Argon, lanzado dos semanas antes, y Google deja clara la división de trabajo: Argon sigue siendo la opción ideal para la mayoría de la ingeniería de software y el trabajo de conocimiento. Carbon es para las tareas que ponen a prueba los límites de un modelo: programación compleja de varios pasos, depuración difícil e investigación científica abierta, usando más tokens que Argon para explorar a fondo, razonar con calma y correr bucles de verificación largos. Tiene una ventana de contexto de hasta un millón de tokens y se identifica en la API como gemini-4-carbon.
Y un matiz que evita una confusión: Carbon no tiene nada que ver con Gemini Omni 1.2 Flash, el modelo de vídeo que Google lanzó el 5 de noviembre y del que hablamos aquí la semana pasada. Omni genera clips de hasta 15 segundos; Carbon razona, programa y busca vulnerabilidades. Son dos familias distintas con el mismo apellido, y este artículo no repite nada de aquel.
El precio: barato por token hasta el 30 de noviembre
El dato que más notarán los desarrolladores es el precio. En la API, Carbon cuesta 2 dólares por millón de tokens de entrada y 10 por millón de salida hasta el 30 de noviembre, el mismo precio de lanzamiento de Argon. A partir del 1 de diciembre, la tarifa se duplica: 4 y 20 dólares. La entrada en caché cuesta 0,10 dólares por millón hasta el 30 de noviembre y 0,20 después. No hay plan gratis: la propia página de precios de Google dice que Carbon no está disponible en el nivel gratuito.
La comparación que Google quiere que hagas es con Anthropic. Claude Fable 5.2, lanzado el día antes, cuesta 8 y 40 dólares por millón de tokens: Carbon sale a la cuarta parte en las dos líneas. A partir del 1 de diciembre, Carbon costará exactamente lo mismo que Claude Opus 5.5, 4 y 20 dólares. La ventana barata dura tres semanas, y Google la anuncia con fecha, no como un descuento sin vencimiento.
La letra pequeña es que el precio por token no es la factura por tarea. Carbon gasta más tokens de razonamiento por turno que Argon —lo dice la propia documentación de Google— y esos tokens se facturan como salida. Un modelo que piensa más tiempo puede salir más caro por tarea aunque cobre menos por token. En la app de Gemini, además, Carbon solo llega a los suscriptores de Google AI Ultra, el plan más caro; los planes Plus y Pro no lo tienen, y The Verge señala que Google no ha dicho cuándo, o si, llegará a los planes inferiores.
Los benchmarks: dónde gana según Google y dónde pierde según los independientes
Google presenta a Carbon como número uno en tres exámenes de agentes de terceros: CursorBench 4.0, de Cursor; WANDR, de Perplexity; y AutomationBench, de Zapier, con un coste por tarea «más de dos veces menor» que el siguiente mejor modelo externo. Son afirmaciones de Google sobre pruebas de terceros, no un ranking independiente, y conviene leerlas así.
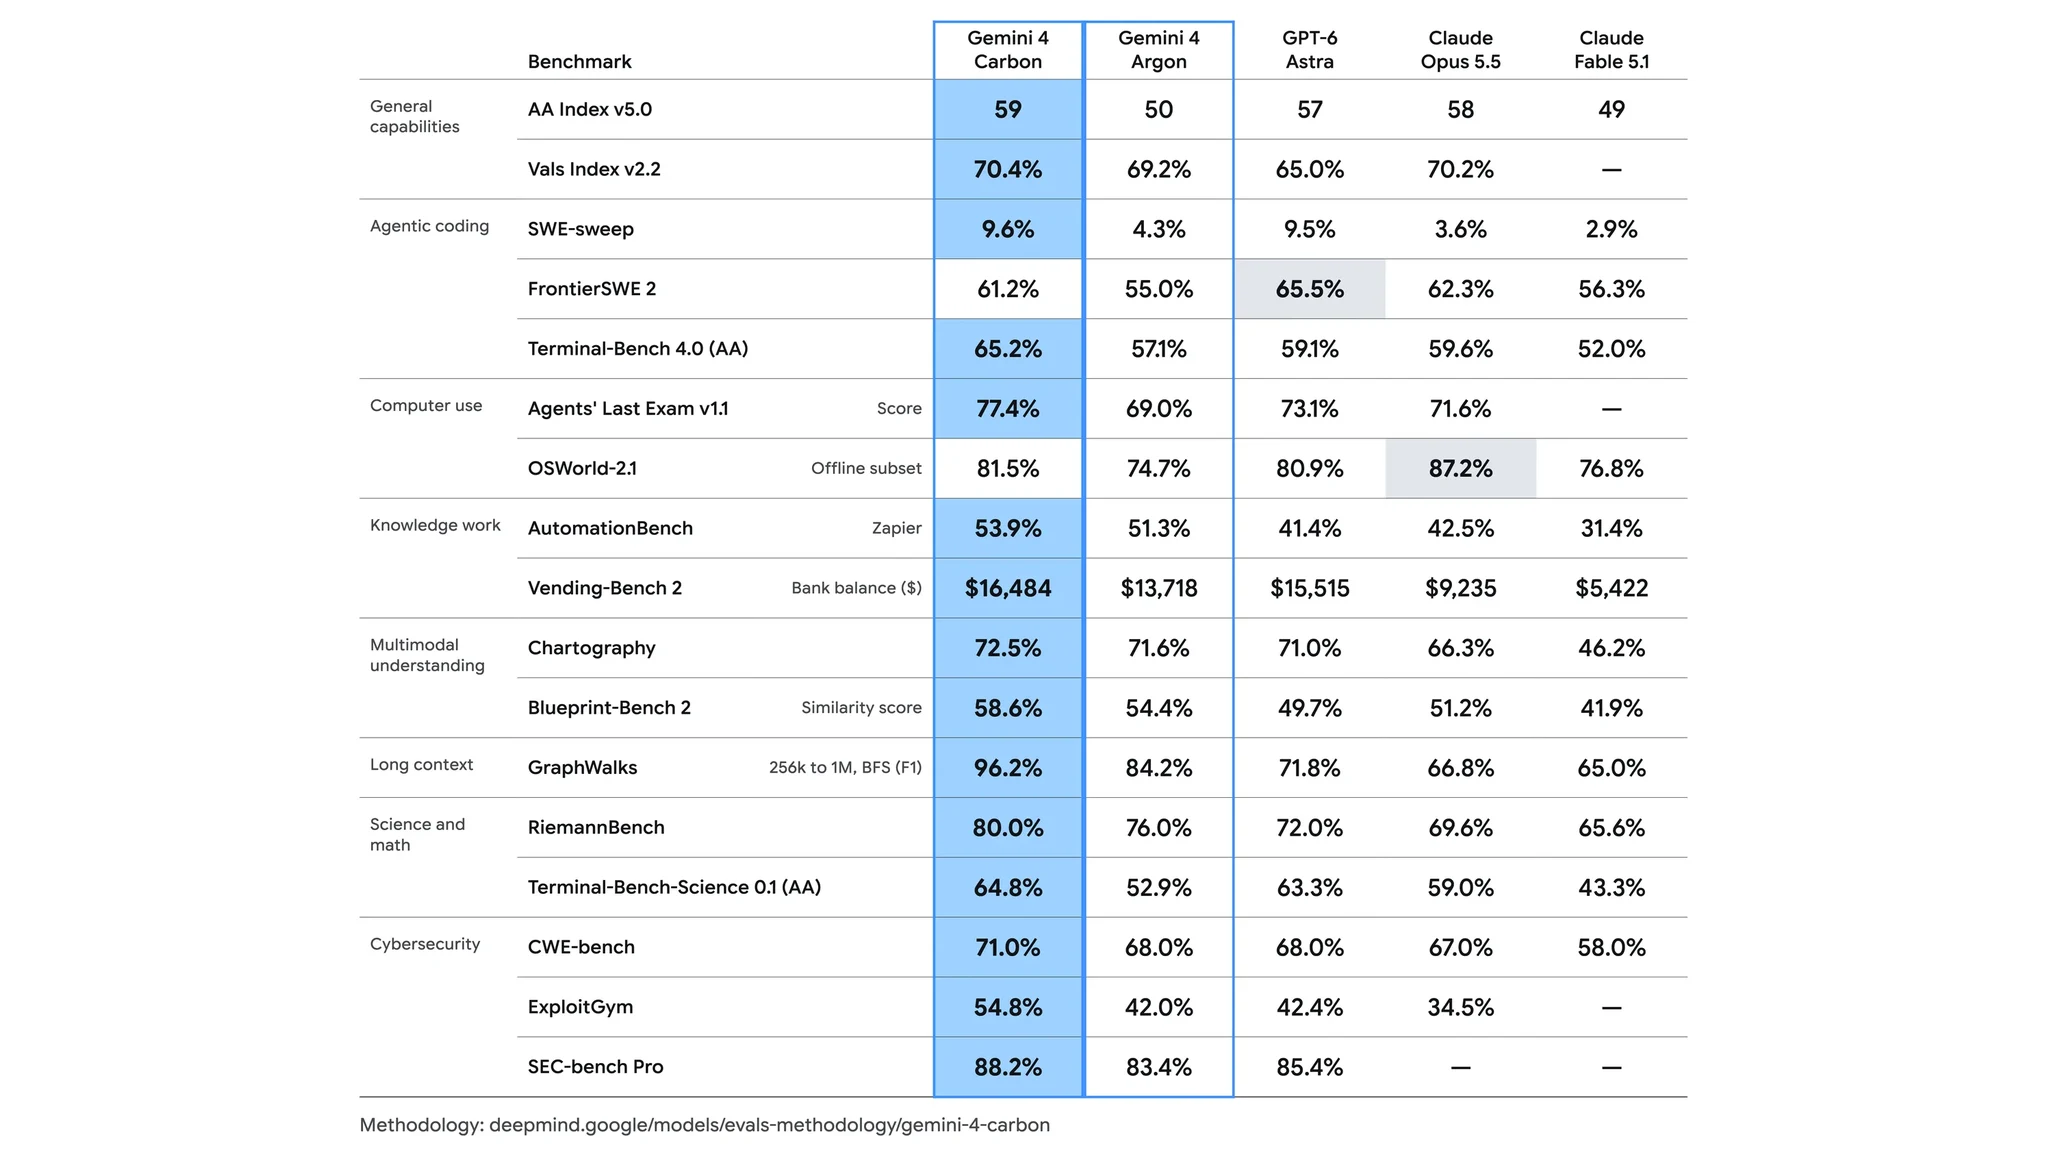
La tabla oficial que Google publicó el 28 de octubre tiene de todo. En el índice de Artificial Analysis v5.0, Carbon marca 59, por delante de Argon con 50, de GPT-6 Astra con 57 y de Opus 5.5 con 58. En AutomationBench llega al 53,9%, frente al 51,3% de Argon y el 31,4% de Fable 5.1. En Terminal-Bench 4.0 marca 65,2%, y en GraphWalks, una prueba de contexto largo, el 96,2%. Pero la misma tabla tiene derrotas: en FrontierSWE 2, Carbon se queda en 61,2% mientras GPT-6 Astra llega al 65,5%, y en OSWorld-2.1, Opus 5.5 lo supera con 87,2% frente a 81,5%.
Google también estrenó con Artificial Analysis un examen nuevo, el Multimodal Knowledge Agent, donde Carbon queda segundo con un coste medio por tarea más de seis veces menor que el modelo que lo supera. Y en finanzas, igualó al mejor modelo probado en la evaluación E2E Financial Agentic de Hebbia y quedó primero entre 23 configuraciones en el índice de inteligencia financiera de Balyasny.
El contrapunto llegó el 11 de noviembre, con el ranking independiente. En el Artificial Analysis Intelligence Index, Carbon marca 60 puntos y queda cuarto, detrás de las tres configuraciones de Fable 5.2: 65 a esfuerzo máximo, 62 a esfuerzo muy alto y 62 a esfuerzo alto. La buena noticia para Google es el precio por tarea: 7,76 dólares para Carbon, frente a 9,08 de Fable a esfuerzo alto y 26,54 a esfuerzo máximo. La mala es el tiempo: Carbon tarda 26,1 minutos de media por tarea, frente a 16,9 de Fable. Y en la tabla de la propia Anthropic, Fable gana en FrontierCode 2.0 con 49,1% frente a 41,1% de Carbon, aunque Carbon devuelve el golpe en AutomationBench con 53,9% frente a 51,4%.
La lectura honesta es que no hay un ganador claro, sino dos modelos con perfiles distintos: Fable lidera el índice general y es más rápido; Carbon es más barato por tarea y gana en los exámenes de trabajo de agente. Quien elija por el titular «número uno» se equivoca en los dos sentidos.
Ciberseguridad: el terreno donde Carbon manda
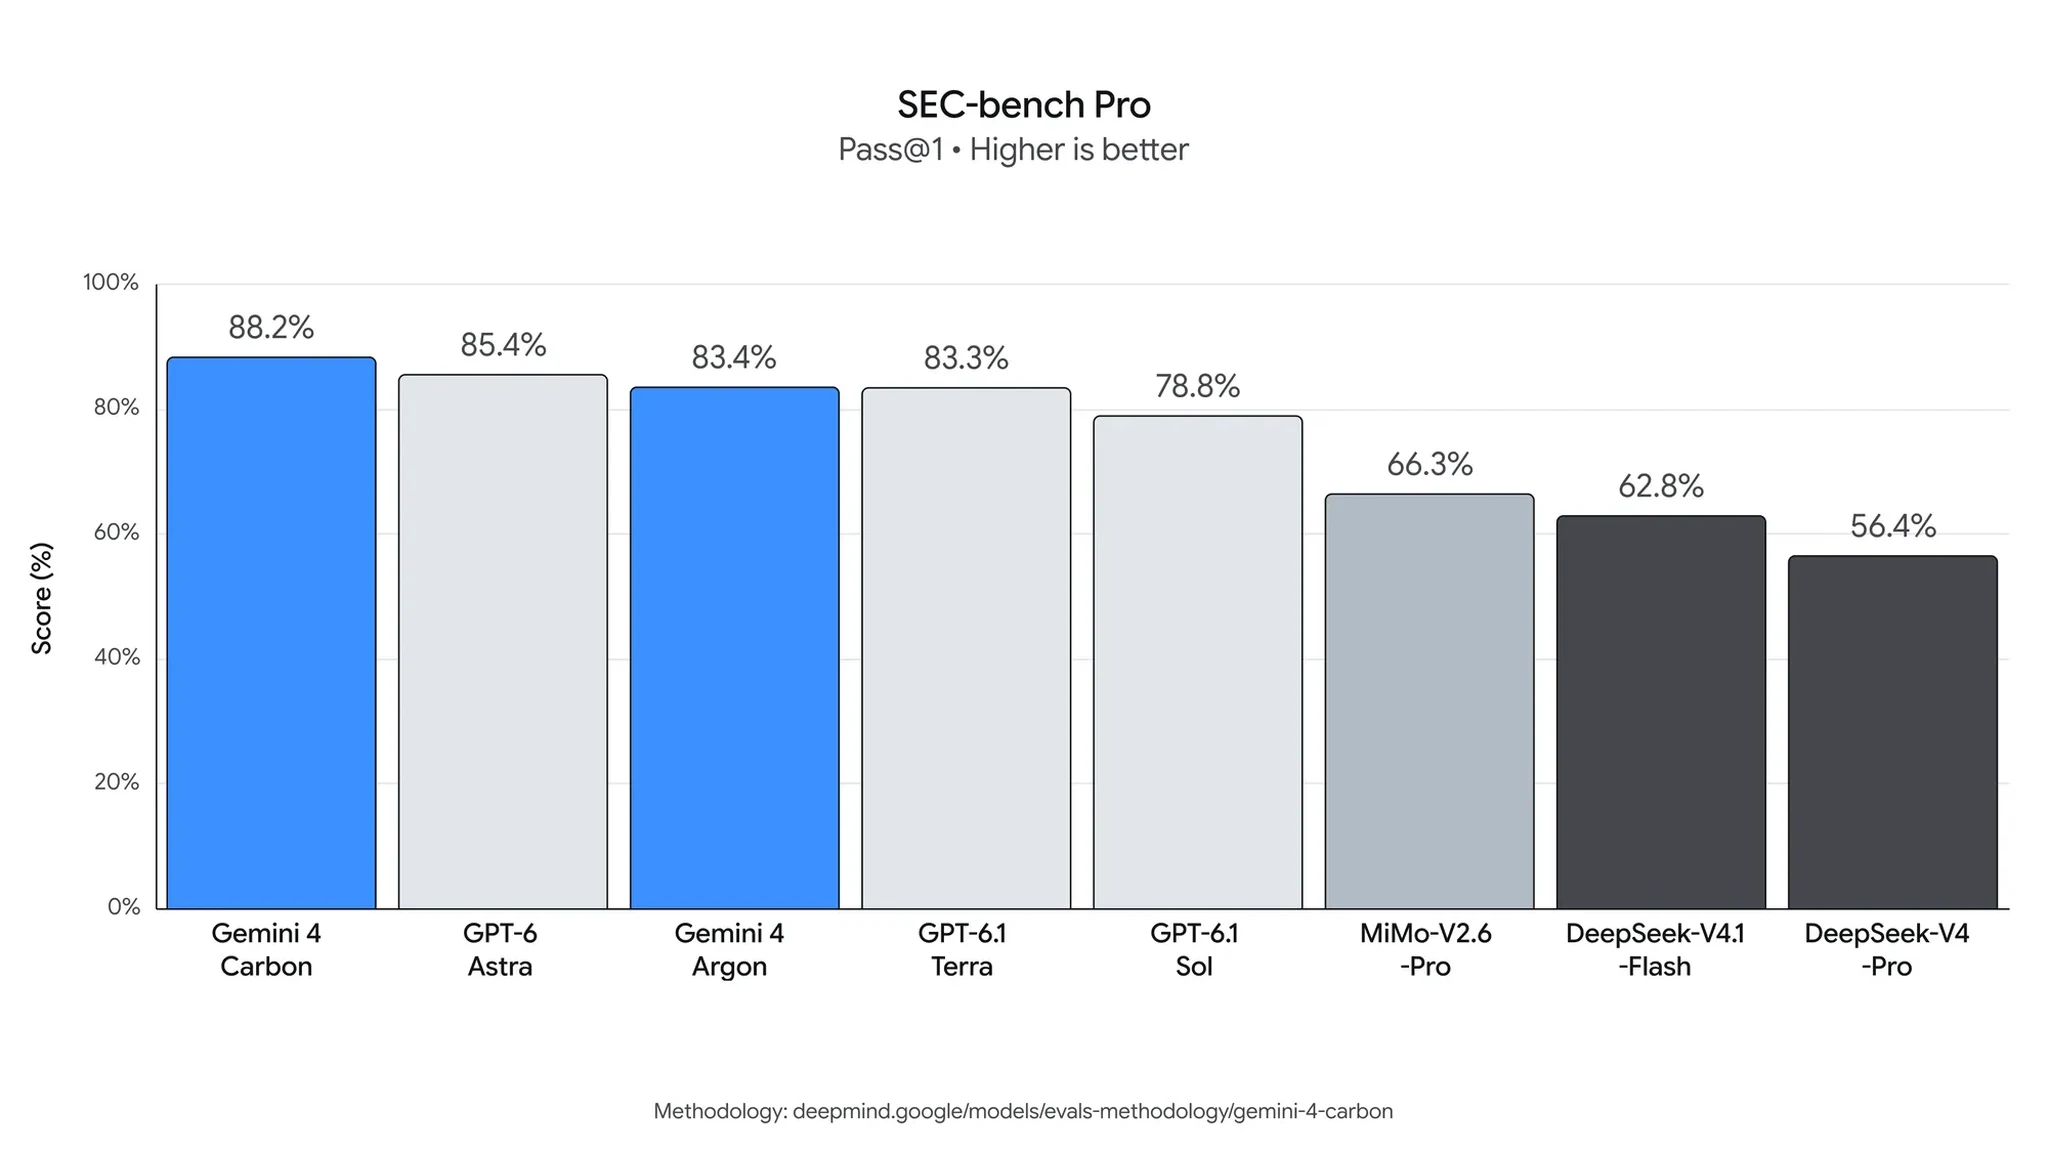
Si hay un terreno donde Carbon no tiene discusión, es la ciberseguridad. Google lo presenta como su modelo más fuerte en defensa, y las cifras que publica son las más altas de su tabla: 88,2% en SEC-bench Pro para encontrar vulnerabilidades, 54,8% en ExploitGym para comprobar si son explotables y 71,0% en CWE-bench para parchearlas. Hay un detalle en letra pequeña que Google mismo anota: esas evaluaciones externas se hicieron sin las salvaguardas activadas.
Los ejemplos de uso real son los que más impresionan. En Project Fortify, el sistema autónomo de Google que escanea, clasifica y remedia, Carbon alcanzó un 100% de recall en el escaneo y un 95% de precisión en la clasificación, en un examen interno, y mejoró en más de un 25% relativo el recall de Argon sobre código abierto. El equipo de investigación de vulnerabilidades de Google Cloud usó Carbon para demostrar que dos fallos en un programa de código abierto muy usado eran vulnerabilidades explotables, de gravedad comparable al exploit PHP2Shell, y los responsables los reclasificaron como críticos. Y en el programa Scan for Good de Wiz, Carbon encontró vulnerabilidades de día cero en menos de dos horas en dos grandes proveedores de software, comprimiendo semanas de investigación en una tarde.
La advertencia que no hay que perderse: las capacidades de ciberseguridad más fuertes no son las del Carbon público. La versión llamada Carbon for cyber solo se entrega a defensores verificados dentro del programa Fairwind. Lo que llega a la API es el modelo general con sus salvaguardas puestas. Es una distinción deliberada, y explica por qué Google guardó el modelo dos semanas.
/swarm y la ciencia: de un enjambre de agentes a verificar el código de Signal
Junto a Carbon, Google presentó en Antigravity una vista previa de /swarm: un comando que convierte un solo prompt en un equipo coordinado de agentes que se puede seguir en tiempo real. La idea es asignar a Carbon los papeles que exigen el razonamiento más profundo —diseño de arquitectura, coordinación y auditoría— mientras modelos más rápidos y ligeros trabajan en paralelo en espacios aislados, con verificadores adversos que ponen a prueba cada cambio.
El ejemplo que Google eligió para presumir no es un benchmark, sino una verificación formal. Con un marco nuevo llamado AlphaProof Code, los investigadores usaron Carbon junto a otros modelos para demostrar matemáticamente las propiedades de seguridad del código de libsignal, la implementación de referencia del protocolo criptográfico de Signal. Los agentes generaron millones de líneas de código en Lean, el lenguaje de las pruebas matemáticas, y completaron en semanas un trabajo que a equipos de expertos les lleva años.
En ciencia, Carbon ya es el modelo principal para la empresa de toxicología Axiom Bio, que dice haber encontrado mecanismos nuevos de toxicidad que no había visto antes. En desarrollo de ensayos de enzimas, el modelo diagnosticó artefactos sutiles de laboratorio a partir de cuadernos y datos crudos, y en predicción de estructuras de proteínas descubrió homólogos remotos en archivos de secuencias a escala de petabases, multiplicando por 40 de media los homólogos recuperados en siete familias del conjunto de prueba CASP17. Google también amplió a Carbon su programa que da acceso gratis durante seis meses a 10.000 científicos.
Seguridad: 99% de ataques bloqueados y cero inyección de prompt
Un modelo con estas capacidades de ciberseguridad necesita frenos a la altura, y Google dedicó buena parte del anuncio a ellos. En entornos simulados de ciberataque, Carbon bloqueó el 99% de las trayectorias de ataque de un agente de red-teaming adaptativo, y la tasa de brecha por intento bajó al 0,8%, frente al 3,1% de Argon. En las pruebas de Gray Swan, la tasa de éxito de consultas de ciberataque automatizado cayó al 2,17%, frente al 9,86% de Argon, y un laboratorio externo, Trajectory Labs, no encontró ningún jailbreak universal nuevo en 132 horas y más de 13.000 peticiones.
El dato que Google más subraya es el de inyección de prompt: Carbon logró un 0% de éxito de ataque en el examen de inyección indirecta de Gray Swan, la primera vez que un modelo alcanza esa marca. En un examen de honestidad de 375 tareas, pasó el 92%, frente al 70% de Argon, negándose a rellenar datos experimentales que faltaban el 98% de las veces. También redujo a cero los intentos exitosos de hacer trampas en Terminal-Bench 4.0 y las alertas graves de desalineación en programación en vivo cayeron casi un 80%.
Son cifras de Google, no de un laboratorio independiente, pero van en la dirección correcta para un modelo que, por diseño, sabe encontrar y explotar vulnerabilidades. La seguridad aquí no es un apartado: es la condición para que el modelo exista fuera de Google.
Quién puede usarlo y cuánto cuesta de verdad
Carbon ya está disponible en la API de pago de Gemini, en AI Studio y en Android Studio, y para empresas en Gemini for business. En consumo, llega a los suscriptores de Google AI Ultra en la app de Gemini, en el modo IA de la búsqueda y en Antigravity. Y el 10 de noviembre, el mismo día de la apertura, GitHub lo puso en disponibilidad general en Copilot para los planes Pro+, Max, Business y Enterprise, con despliegue gradual y facturación al precio de lista del proveedor.
La propia Google recomienda no empezar por Carbon. Para la mayoría del trabajo de ingeniería y conocimiento, su consejo es Argon, y subir a Carbon solo cuando la tarea lo exija: migraciones de varios paquetes, investigaciones de causa raíz entre subsistemas o rediseños de arquitectura. Carbon tiene niveles de razonamiento configurables —bajo, medio y alto— para cambiar calidad por latencia y coste, y Google advierte que a niveles altos puede ser lento, agotar tiempos o gastar más tokens para rendir al máximo.
El coste real depende de cuánto se le pida pensar. A esfuerzo alto, Carbon cuesta 7,76 dólares por tarea en el índice de Artificial Analysis, menos que Fable 5.2 a esfuerzo alto, pero más del doble que a esfuerzo medio en otros exámenes. Y la ventana barata tiene fecha: quien construya su presupuesto sobre los 2 y 10 dólares se llevará una sorpresa el 1 de diciembre, cuando la tarifa sea de 4 y 20. La lección es la misma que con Fable 5.2: la cifra del anuncio es el suelo, no la factura.
El lanzamiento llega en plena ebullición: la misma semana, Anthropic abrió Fable 5.2 y Mythos 5.2, y Google respondió en 24 horas con su modelo más fuerte a un cuarto del precio por token. Con Carbon, Google no compite en vídeo ni en voz: compite en hacer el trabajo técnico más difícil, más barato por tarea que nadie. En los exámenes de agente, al menos sobre el papel, lo ha conseguido. La prueba de verdad empezará ahora, fuera de los laboratorios de Google.
Preguntas frecuentes
¿Gemini 4 Carbon es gratis?
No. En la API solo está en el nivel de pago, sin plan gratuito, y en la app de Gemini solo para suscriptores de Google AI Ultra. Los planes Plus y Pro no lo incluyen.
¿Carbon reemplaza a Gemini 4 Argon?
No. Google recomienda Argon para la mayoría del trabajo de ingeniería y conocimiento, y Carbon para las tareas más difíciles: código largo, depuración compleja, ciberseguridad e investigación científica.
¿Carbon es mejor que Claude Fable 5.2?
Depende de la prueba. Fable lidera el índice general de Artificial Analysis con 62 a esfuerzo alto y 65 a esfuerzo máximo, frente a 60 de Carbon, y gana en FrontierCode 2.0. Carbon gana en AutomationBench y en Terminal-Bench 4.0, y cuesta menos por tarea a esfuerzo alto: 7,76 dólares frente a 9,08.
¿Qué es Carbon for cyber?
La versión de Carbon con las capacidades de ciberseguridad completas, que solo se entrega a defensores verificados dentro del programa Fairwind de Google. El Carbon público lleva las salvaguardas activadas.
Síguenos para más noticias de tecnología: X @EcuadorGeek e Instagram @EcuadorGeek.


